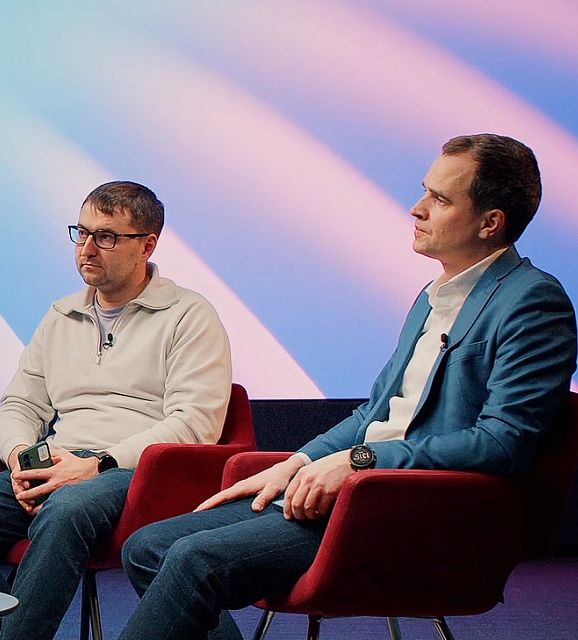
Василий Король, директор направления Data & Digital компании AstraZeneca, и Петр Пузанов, руководитель направления по автоматизации инструментальных исследований N3.Health, поговорили с Дамиром Суховым, партнером Kept, руководителем практики по работе с компаниями сферы здравоохранения и фармацевтики, о том, какие результаты искусственный интеллект дает в лечении и диагностике, как использовать медицинские данные и что ждет российский рынок цифрового здравоохранения.
Содержание

Сегодня много говорят об искусственном интеллекте в диагностике и лечении. Василий, вы отвечаете за направление Data & Digital в AstraZeneca. Какие направления использования ИИ уже дают реальный ощутимый результат для пациентов и врачей?
Василий Король: ИИ в первую очередь дает эффект в операционных процессах. Но если мы говорим про лечение и диагностику, я бы выделил три ключевых направления. Здесь ИИ скорее выступает помощником врачей, пациентов, а не заменяет людей.
Прежде всего, продвинутые технологии качественно улучшили диагностику с точки зрения распознавания снимков. Например, в 2021 году мы участвовали в разработке анализа КТ-снимков рака легкого. По результатам этого пилотного проекта использование анализатора позволило на 10% улучшить качество диагностики.
Второе — системы поддержки принятия врачебных решений. В этом направлении мы также сотрудничаем с различными организациями для развития систем поддержки принятия решений (СППВР), медицинских информационных систем (МИС), которые позволяют врачу на основании данных эффективнее принимать решения о диагнозе. СППВР собирают все факторы о пациенте в системе и «подсвечивают» врачу, какие вопросы задать, куда лучше пациента направить и какие дополнительные анализы назначить.
И третье — клинические исследования, самый длительный процесс в рамках производства и создания лекарственного препарата. Постепенно в этом секторе начинают рождаться цифровые двойники, которые позволяют проверить, насколько те или иные сегменты пациентов воспринимают различные лекарственные препараты. Такие проекты ускорят клинические исследования и, конечно, повлияют на стоимость. R&D в рамках производства лекарств — самый трудозатратный процесс. Мы тратим почти 25% выручки на R&D ежегодно. Это большой объем инвестиций.
Прежде всего, продвинутые технологии качественно улучшили диагностику с точки зрения распознавания снимков. Например, в 2021 году мы участвовали в разработке анализа КТ-снимков рака легкого. По результатам этого пилотного проекта использование анализатора позволило на 10% улучшить качество диагностики.
Второе — системы поддержки принятия врачебных решений. В этом направлении мы также сотрудничаем с различными организациями для развития систем поддержки принятия решений (СППВР), медицинских информационных систем (МИС), которые позволяют врачу на основании данных эффективнее принимать решения о диагнозе. СППВР собирают все факторы о пациенте в системе и «подсвечивают» врачу, какие вопросы задать, куда лучше пациента направить и какие дополнительные анализы назначить.
И третье — клинические исследования, самый длительный процесс в рамках производства и создания лекарственного препарата. Постепенно в этом секторе начинают рождаться цифровые двойники, которые позволяют проверить, насколько те или иные сегменты пациентов воспринимают различные лекарственные препараты. Такие проекты ускорят клинические исследования и, конечно, повлияют на стоимость. R&D в рамках производства лекарств — самый трудозатратный процесс. Мы тратим почти 25% выручки на R&D ежегодно. Это большой объем инвестиций.
Вы уже начали говорить о проектах, на которые AstraZeneca делает упор в рамках работы с ИИ. Как оценить факторы успеха той или иной инициативы? Как вы их ранжируете, чтобы определить, в какое направление вкладываться?
В. К.: У нас есть два аспекта. Первый — как у любой компании: операционная эффективность, понятные для всех показатели, на основании которых происходят ранжирование и приоритизация, плюс экономическая целесообразность.
Но есть второй аспект — важная миссия: сделать рак излечимым заболеванием. Поэтому мы смотрим, ранжируем и приоритизируем применение технологий часто и на основании R&D-специфики.
Это новая возможность, которой раньше не было. Именно поэтому совместно с NVIDIA и другими шведскими компаниями AstraZeneca открывает в Швеции хаб по разработке ИИ для поиска новых молекул. Это позволит ускорить процесс и немножко приоткрыть горизонты — масштаб задач, которые можно обрабатывать в таком хабе, значительно больше, чем при использовании только человеческих ресурсов.
Кроме того, если говорить не про операционную эффективность, а про новые возможности, то мы развиваем системы поддержки принятия врачебных решений. В конце 2024 — начале 2025 года совместно с UK Healthcare создали систему Milton — проанализировали более 500 тыс. медицинских карт в биобанке Великобритании с помощью ИИ. Это повысило прогнозируемость возможных будущих заболеваний у этих пациентов. Конечно, работа проводилась при поддержке государства и с согласия пациентов. Но здесь сошлись все три момента, которые нужны для успешной реализации решений на базе ИИ. Первое — технологии, они уже были доступны. Второе — компетенции, которые есть у нас. И третье — данные. Если соединить все вместе, получается ценностный продукт для инноваций, здравоохранения и в итоге — для пациентов.
Кроме того, если говорить не про операционную эффективность, а про новые возможности, то мы развиваем системы поддержки принятия врачебных решений. В конце 2024 — начале 2025 года совместно с UK Healthcare создали систему Milton — проанализировали более 500 тыс. медицинских карт в биобанке Великобритании с помощью ИИ. Это повысило прогнозируемость возможных будущих заболеваний у этих пациентов. Конечно, работа проводилась при поддержке государства и с согласия пациентов. Но здесь сошлись все три момента, которые нужны для успешной реализации решений на базе ИИ. Первое — технологии, они уже были доступны. Второе — компетенции, которые есть у нас. И третье — данные. Если соединить все вместе, получается ценностный продукт для инноваций, здравоохранения и в итоге — для пациентов.
Действительно важная триада для гарантированного успеха. Петр, расскажите, пожалуйста, про направления использования ИИ в N3.Health. И что, на ваш взгляд, мешает компаниям отрасли быстрее адаптироваться к цифровым изменениям?
Петр Пузанов: Компания N3.Health развивает платформу обмена данными в коммерческом сегменте. В нашу группу компаний входит «Нетрика Медицина», которая имеет схожую задачу, но в государственном секторе. И про каждое из направлений нужно говорить отдельно. Если в коммерческой медицине за ИИ взялись только самые крупные игроки, то в государственном сегменте уже давно работают различные решения, например «МосМедИИ». Началось развитие и эксплуатация региональных централизованных архивов данных: например, центральные архивы медицинских изображений (ЦАМИ), которые косвенно помогают собрать необходимый массив информации — топливо для ИИ. Развиваются и федеральные реестры, аккумулирующие медицинские данные из государственных медучреждений региона и коммерческих клиник, работающих по ОМС.
Однако есть важный нюанс. Данные, которые собираются в государственной медицине, сильно отличаются как по качеству, так и по доступности от данных коммерческой медицины. Врач, работающий в госсекторе, может изучить всю информацию по своему пациенту в регионе: собрать, проанализировать, сделать выводы с использованием разных видов ИИ.
Однако есть важный нюанс. Данные, которые собираются в государственной медицине, сильно отличаются как по качеству, так и по доступности от данных коммерческой медицины. Врач, работающий в госсекторе, может изучить всю информацию по своему пациенту в регионе: собрать, проанализировать, сделать выводы с использованием разных видов ИИ.
Например, если говорить про системы помощи принятия врачебных решений, то ИИ на основе истории болезни сформулирует основные тезисы о здоровье, найденных патологиях пациента, рекомендациях и даст прочую полезную для врача информацию. Основываясь на ней, специалист назначит терапию. Но в коммерции таких решений крайне мало.
Их только подключают, потому что в первую очередь все упирается в экономическую эффективность такого внедрения. Для всех процессов на базе ИИ нужны вычислительные мощности, а это требует вложений.
В государственном сегменте активно проводится работа с процессами автоматизации управленческих решений для региональных органов власти в здравоохранении, в том числе для МИАЦ. Использование ИИ здесь — от процесса записи пациента до аналитических систем. Реализуется аналитическая платформа, которая собирает данные из всех сегментов медицины и медицинских информационных систем. Региональное здравоохранение принимает управленческие решения, основываясь в числе прочего на данных аналитической платформы. У компании «Нетрика Медицина», например, есть своя регистровая платформа, с которой можно общаться «человеческим» языком. Например: сколько у нас пациентов, с какими проблемами обращаются, какие лекарства нужно заказать, каких врачей в перспективе будет не хватать, какой план найма необходимо осуществить.
В государственном сегменте активно проводится работа с процессами автоматизации управленческих решений для региональных органов власти в здравоохранении, в том числе для МИАЦ. Использование ИИ здесь — от процесса записи пациента до аналитических систем. Реализуется аналитическая платформа, которая собирает данные из всех сегментов медицины и медицинских информационных систем. Региональное здравоохранение принимает управленческие решения, основываясь в числе прочего на данных аналитической платформы. У компании «Нетрика Медицина», например, есть своя регистровая платформа, с которой можно общаться «человеческим» языком. Например: сколько у нас пациентов, с какими проблемами обращаются, какие лекарства нужно заказать, каких врачей в перспективе будет не хватать, какой план найма необходимо осуществить.
Одно из главных направлений, о котором мы уже начали говорить, — работа с медицинскими данными. Если 5–7 лет назад все было в режиме эксперимента, то сейчас очевидно, что это стратегический актив для развития и фармацевтики, и других направлений здравоохранения. Как медицинские данные повлияли на развитие ИИ? Какой путь уже пройден и какие факторы для дальнейшего развития рынка вы можете выделить?
В. К.: Уровень развития технологий на основании больших данных разнится в зависимости от региона. По последним оценкам, мировой рынок медданных в 2026 году достигнет порядка 80 млрд долл. США, в 2031 году — 193 млрд долл. США. Таким образом, ежегодный рост составит 19–20%.
Если у нас есть доступ к обезличенным сгруппированным датасетам, то скорость принятия решений на доклинике ускоряется на 25–50%.
Мы можем лучше стратегически планировать производственные мощности — за счет понимания потребности в препаратах прогнозируем, как загрузить или расширить производство.
Пока, к сожалению, не в каждой стране есть доступ к обезличенным агрегированным датасетам.
П. П.: Погрузимся немного в историю. Примерно в 2012 году я в первый раз услышал о data science и вообще не понял, что это такое. Стратегический проект по цифровизации здравоохранения появился в конце 2018 года (федеральный проект «Создание единого цифрового контура в здравоохранении на основе единой государственной информационной системы в сфере здравоохранения (ЕГИСЗ)»). Благодаря ему начались масштабные внедрения сквозных систем учета всех медицинских данных на уровне региона. Тогда и начали формироваться единые массивы данных, а также мы стали слышать о российских компаниях, занимающиеся ИИ. Среди основных решений — рентген легких, маммография, КТ.
Однако и здесь есть нюансы. Например, МРТ-снимки менее стандартизированные, и их количество значительно меньше, чем снимков других модальностей. ИИ-решений по МРТ в России существенно меньше, чем по другим направлениям. А если говорить про данные из истории болезни, представленные в виде текста, написанного врачом, то их нельзя считать достоверным источником для обучения моделей: мы не можем быть уверены, что информация не искажена или не внесена формально. Есть много архивов, которые можно отсканировать, и сервисы позволяют это делать.
Пока, к сожалению, не в каждой стране есть доступ к обезличенным агрегированным датасетам.
П. П.: Погрузимся немного в историю. Примерно в 2012 году я в первый раз услышал о data science и вообще не понял, что это такое. Стратегический проект по цифровизации здравоохранения появился в конце 2018 года (федеральный проект «Создание единого цифрового контура в здравоохранении на основе единой государственной информационной системы в сфере здравоохранения (ЕГИСЗ)»). Благодаря ему начались масштабные внедрения сквозных систем учета всех медицинских данных на уровне региона. Тогда и начали формироваться единые массивы данных, а также мы стали слышать о российских компаниях, занимающиеся ИИ. Среди основных решений — рентген легких, маммография, КТ.
Однако и здесь есть нюансы. Например, МРТ-снимки менее стандартизированные, и их количество значительно меньше, чем снимков других модальностей. ИИ-решений по МРТ в России существенно меньше, чем по другим направлениям. А если говорить про данные из истории болезни, представленные в виде текста, написанного врачом, то их нельзя считать достоверным источником для обучения моделей: мы не можем быть уверены, что информация не искажена или не внесена формально. Есть много архивов, которые можно отсканировать, и сервисы позволяют это делать.
Поэтому по‑настоящему надежные ИИ‑решения должны строиться на данных, которые не изменяются человеком, — инструментальных исследованиях, изображениях, объективных измерениях.
Поговорим про общий рынок и те оценки, которые есть в настоящий момент. В прошлом году мы сделали первое в России исследование рынка медицинских данных: опросили более 50 экспертов из фармкомпаний, медицинских организаций, лабораторий, компаний ИТ-сектора. И действительно есть большой потенциал роста. Конечно, рынок сейчас — всего лишь несколько миллиардов рублей. Но он ограничен российским законодательным ландшафтом. Как использование медицинских данных может способствовать развитию нашего рынка?
П. П.: Первое, что хотелось бы подсветить, — сейчас нельзя использовать понятие обезличенных данных. Обезличенными данными могут заниматься только федеральные ведомства, согласно закону. Поэтому мы переходим к понятию «агрегированные данные». А что такое агрегированные данные? Чем отличаются от обезличенных? Вопрос, который юридически не до конца проработан. Ни одна медицинская организация не хочет рисковать, занимаясь обезличиванием медицинских данных, и создавать решения. Вопросов очень много, и медицинские организации, опасаясь рисков, не готовы самостоятельно интерпретировать закон. И для конкретных решений нужно проработать этот юридический аспект. В результате рынок развивается медленно.
Важным является и тот факт, что всем медицинским информационным системам нужен обмен данными, но для обмена данными между потенциальными конкурентами должен быть определен стандарт обмена, чтобы создавалась открытая экосистема данных. В России существует более 200 медицинских информационных систем, из них не более 20 работают в региональном здравоохранении. К примеру, в Москве работает единая медицинская информационная система. В Санкт-Петербурге до сих пор используется интеграционный подход, когда в региональном здравоохранении работают разные вендоры, которые связаны определенным стандартом взаимодействия. Таким форматом является международный стандарт HL7 FHIR, который позволяет обмениваться структурированными медицинскими данными, а также протокол обмена DICOM в инструментальной диагностике. При работе по стандартам появляется уверенность в том, что информация интероперабельна, доступна и может быть синхронизирована с различными федеральными сервисами.
Сегодня невозможно внутри одной компании закрыть все компетенции. Например, в N3.Health мы сильны в обмене данными, аналитике, навигации пациента, сервисах для взаимодействии медорганизации с пациентами, но не занимаемся компьютерным зрением. Поэтому мы работаем в партнерстве с другими игроками — не конкурируя, а дополняя друг друга. Например, наше партнерство с разработчиком «Платформа “Третье мнение”» позволяет быстрее закрывать потребности клиники в компьютерном зрении «по запросу». Наша задача — сделать так, чтобы врач мог использовать ИИ‑сервисы нативно, в привычном рабочем процессе.
Важным является и тот факт, что всем медицинским информационным системам нужен обмен данными, но для обмена данными между потенциальными конкурентами должен быть определен стандарт обмена, чтобы создавалась открытая экосистема данных. В России существует более 200 медицинских информационных систем, из них не более 20 работают в региональном здравоохранении. К примеру, в Москве работает единая медицинская информационная система. В Санкт-Петербурге до сих пор используется интеграционный подход, когда в региональном здравоохранении работают разные вендоры, которые связаны определенным стандартом взаимодействия. Таким форматом является международный стандарт HL7 FHIR, который позволяет обмениваться структурированными медицинскими данными, а также протокол обмена DICOM в инструментальной диагностике. При работе по стандартам появляется уверенность в том, что информация интероперабельна, доступна и может быть синхронизирована с различными федеральными сервисами.
Сегодня невозможно внутри одной компании закрыть все компетенции. Например, в N3.Health мы сильны в обмене данными, аналитике, навигации пациента, сервисах для взаимодействии медорганизации с пациентами, но не занимаемся компьютерным зрением. Поэтому мы работаем в партнерстве с другими игроками — не конкурируя, а дополняя друг друга. Например, наше партнерство с разработчиком «Платформа “Третье мнение”» позволяет быстрее закрывать потребности клиники в компьютерном зрении «по запросу». Наша задача — сделать так, чтобы врач мог использовать ИИ‑сервисы нативно, в привычном рабочем процессе.
Василий, что мешает рынку деперсонализированных агрегированных данных развиваться? И как можно этому помочь?
В. К.: Поддержу все тезисы, которые озвучил Петр. Особенно первый, о юридическом аспекте использования данных — мне кажется, он главный. Мы пока не договорились между собой и с государством, что такое обезличенные и агрегированные данные. Это один из ключевых ограничителей, который мешает двигаться дальше.
Если мы говорим про регуляторику, нужен однозначный и прозрачный механизм обмена такими данными.
У нас есть единая государственная информационная система в сфере здравоохранения (ЕГИСЗ), где за год прошло около 2 млрд электронных медицинских документов. Но это не система, которая агрегирует данные, — скорее, проводник электронных документов.
Таким образом, сначала необходимо решить вопрос однозначных определений, дальше — прописать четкий и прозрачный механизм работы с обезличенными данными. Это можно сделать безопасно. Например, данные хранятся обезличенно у государства, а компании могут получать доступ через «Госуслуги» или другим способом. Технологий много. Главное, чтобы у всех сторон было желание: у индустрии, тех, кто работает с данными, ИТ-компаний и государства.
Таким образом, сначала необходимо решить вопрос однозначных определений, дальше — прописать четкий и прозрачный механизм работы с обезличенными данными. Это можно сделать безопасно. Например, данные хранятся обезличенно у государства, а компании могут получать доступ через «Госуслуги» или другим способом. Технологий много. Главное, чтобы у всех сторон было желание: у индустрии, тех, кто работает с данными, ИТ-компаний и государства.
С компаниями понятно, они получат новый поток информации для принятия решений, R&D-разработок, создания новых продуктов ИИ. Петр, а как централизованный доступ к медицинским данным — обезличенным, агрегированным — повлияет на врачей и пациентов?
П. П.: Важно помнить о рисках. Хорошая новость заключается в том, что ИИ помогает врачу отойти от рутинных процессов и заняться непосредственно лечением. История болезни, собранная за много лет, должна приходить к врачу вместе с пациентом. Даже если пациент что-то забудет, то история болезни вспомнит. Дальше включается клинический опыт врача. Именно его пытается повторить ИИ. Получается, что ИИ может существенно помочь врачу, но он не должен становиться источником безусловной истины. Есть опасность слепого доверия системе, особенно в тех областях, где у специалиста меньше экспертизы. Поэтому ответственность за диагноз и лечение в любом случае остается на враче, а ИИ должен восприниматься как инструмент поддержки, а не замена клинического мышления.
Для пациента взаимодействие с ИИ должно начаться с электронных согласий. Человек должен понимать, какие данные он предоставляет, кто и для каких целей их использует, и иметь возможность управлять этим доступом. Только при прозрачных и понятных механизмах доверие к цифровому здравоохранению сможет устойчиво расти.
Для пациента взаимодействие с ИИ должно начаться с электронных согласий. Человек должен понимать, какие данные он предоставляет, кто и для каких целей их использует, и иметь возможность управлять этим доступом. Только при прозрачных и понятных механизмах доверие к цифровому здравоохранению сможет устойчиво расти.
При качественной реализации цифрового здравоохранения пациент должен получить больше выгоды для своего здоровья, чем возможных сопутствующих рисков.
Это действительно важный аспект, который нужно учитывать. Тут, наверное, нужно очень правильно построить взаимодействие. Василий, медицинские данные, пусть и деперсонализированные, агрегированные, — очень чувствительная информация. И мы все это понимаем. Какие технологии позволяют гарантировать защиту этих персональных данных пациентов?
В. К.: На самом деле, мы не первые, кто использует эти технологии. Например, есть единая биометрическая система, к которой имеют доступ коммерческие банки. И мы научились — и как государство, и как индустрия — безопасно работать с этими данными с точки зрения компетенций. Есть примеры также из других отраслей. Сейчас много различных подходов, которые позволяют, не трогая детальные данные, обучать и создавать именно прогностические модели.
Технологий конфиденциальных вычислений достаточно много: федеративное обучение, когда модель обучается локально в системе; федеративная аналитика, когда вместо обучения организации создают агрегированную аналитику. Есть еще Data Cleanroom — по сути, такая же песочница, где в безопасной среде разные организации работают с данными, при этом не трогая детальные данные, и обучают большую прогностическую модель, например, пациентскую.
Самое важное, чтобы мы были готовы эти технологии использовать. В конце прошлого года я был на конференции Минцифры, и мы обсуждали, что это возможно.
П. П.: Если мы говорим про обмен данными между медицинскими организациями, то это в первую очередь шифрование по ГОСТ. Этих производителей не так много, и мы можем их пересчитать по пальцам. В других странах для шифрования персональных данных достаточно открытых протоколов шифрования, поэтому вопрос обмена решается проще.
Особенно хорошо эту проблему понимают федеральные медицинские центры. Именно там сосредоточены наиболее ценные массивы данных: более полные истории болезни, глубже описанные протоколы приема, сложные клинические случаи, представляющие большую ценность для аналитики и обучения моделей. Однако даже крупной организации часто недостаточно объема данных, чтобы получить по-настоящему масштабный эффект в одиночку.
Технологий конфиденциальных вычислений достаточно много: федеративное обучение, когда модель обучается локально в системе; федеративная аналитика, когда вместо обучения организации создают агрегированную аналитику. Есть еще Data Cleanroom — по сути, такая же песочница, где в безопасной среде разные организации работают с данными, при этом не трогая детальные данные, и обучают большую прогностическую модель, например, пациентскую.
Самое важное, чтобы мы были готовы эти технологии использовать. В конце прошлого года я был на конференции Минцифры, и мы обсуждали, что это возможно.
П. П.: Если мы говорим про обмен данными между медицинскими организациями, то это в первую очередь шифрование по ГОСТ. Этих производителей не так много, и мы можем их пересчитать по пальцам. В других странах для шифрования персональных данных достаточно открытых протоколов шифрования, поэтому вопрос обмена решается проще.
Особенно хорошо эту проблему понимают федеральные медицинские центры. Именно там сосредоточены наиболее ценные массивы данных: более полные истории болезни, глубже описанные протоколы приема, сложные клинические случаи, представляющие большую ценность для аналитики и обучения моделей. Однако даже крупной организации часто недостаточно объема данных, чтобы получить по-настоящему масштабный эффект в одиночку.
Поэтому перспективной, на мой взгляд, моделью выглядит федеративный подход: объединение медицинских вузов и центров в единую сеть с защищенными каналами связи и понятным механизмом согласия пациентов.
При этом данные должны быть размечены, валидированы и подготовлены для использования, а за сам процесс должны отвечать конкретные специалисты и команды. На такой базе можно строить действительно сильные решения. Но пока сохраняется тот же ключевой барьер: отсутствие полной юридической определенности. Организации опасаются быть первыми, пока не поймут, насколько такой формат работы однозначно будет поддержан регуляторно.
Сформировалась ли модель работы с деперсонализированными агрегированными данными за рубежом? Какие страны демонстрируют лучшие практики? И какую ценность несет этот доступ к данным для разных стейкхолдеров?
В. К.: Начну с конца. Насколько я помню, как раз в вашем исследовании (прим. ред. — результаты исследования рынка медицинских данных в России можно посмотреть по ссылке) указывалось, что в Европе оценивают эффект от использования медданных в 11 миллиардов евро в ближайшие годы. И прогнозируют ощутимое влияние на ВВП стран. Если посмотреть на те же США, то мы видим, что все больше и больше бигтеха заходит в медтех, работу с данными. Microsoft, например, сделал copilot (прим. ред. — Microsoft Copilot Health, ИИ-сервис) для врача, который записывает за пациентом и, во-первых, снимает с врача нагрузку, а во-вторых, улучшает полноту и качество заполнения медицинских информационных систем в моменте, когда происходит прием. То есть такие решения рождаются. И Google, и Amazon — все уже там. Apple тоже выпускает свои инструменты для сбора, анализа и обработки таких данных.
Когда большие технологические компании понимают, что это будет интересно, в том числе коммерчески, они начинают туда инвестировать.
Если мы говорим про конкретные кейсы, то я бы отметил китайский бум биотехиндустрии за последние 10 лет. Это связано в том числе и с доступом к обезличенным датасетам, которые позволяют качественно обучать различные модели. К сожалению, даже если посмотреть на нашу страну — различные медучреждения, регионы, — данные есть, но их не так много, чтобы получить качественный, статистически значимый результат. В Китае средний регион насчитывает около 40 млн жителей. Поэтому даже на региональном уровне на базе этих данных гораздо легче получить статистически значимые результаты. Это одна из причин, почему там и идет такой активный бум биотехиндустрии.
Также есть точечные примеры в других странах. Например, врачи в Торонто из больницы Святого Михаила решили проверить эффективность использования предиктивной аналитики. Они обсудили с пациентами, подписали все необходимые согласия, что будут все их данные обрабатывать с помощью ИИ, и это позволит терапевтам в числе прочего предиктивно рекомендовать методы лечения. Результаты теста показали, что риск внезапной смерти снизился на 26%. На основе прогностических моделей врачи предлагали сделать дополнительные анализы или меняли терапию, что позволяло спасать жизни.
П. П.: За рубежом ценность открытых и хорошо организованных медицинских данных уже давно подтверждается на практике. В качестве примера можно привести проекты, связанные с анализом МРТ-изображений новорожденных. В России таких данных немного, они сосредоточены лишь в отдельных перинатальных центрах. В США при этом существуют открытые массивы изображений, на основе которых проводятся хакатоны, исследования и разработка алгоритмов для более точной разметки и интерпретации данных.
Это особенно важно в тех областях, где знаний и наблюдений пока недостаточно. Например, раннее развитие мозга ребенка все еще изучено значительно хуже, чем более поздние этапы. А качественные данные могут помочь выявлять патологии существенно раньше.
Еще один важный фактор — масштабная грантовая поддержка. Во многих странах медицинские организации объединяются вокруг исследовательских задач, формируют крупные датасеты и развивают прикладную аналитику, в том числе в реанимации и прогнозировании состояния пациента. Там, где такие массивы уже накоплены, информационные системы могут не просто фиксировать происходящее, а прогнозировать развитие ситуации и подсказывать момент, когда терапию нужно начинать незамедлительно.
Кроме того, в зарубежной практике уже появляются сервисы, которые помогают пациенту консолидировать медицинские данные из разных клиник в едином контуре. Это важный ориентир для будущего развития: пациент должен иметь понятный и управляемый доступ к собственному медицинскому профилю, а не зависеть от разрозненных систем разных медорганизаций.
Также есть точечные примеры в других странах. Например, врачи в Торонто из больницы Святого Михаила решили проверить эффективность использования предиктивной аналитики. Они обсудили с пациентами, подписали все необходимые согласия, что будут все их данные обрабатывать с помощью ИИ, и это позволит терапевтам в числе прочего предиктивно рекомендовать методы лечения. Результаты теста показали, что риск внезапной смерти снизился на 26%. На основе прогностических моделей врачи предлагали сделать дополнительные анализы или меняли терапию, что позволяло спасать жизни.
П. П.: За рубежом ценность открытых и хорошо организованных медицинских данных уже давно подтверждается на практике. В качестве примера можно привести проекты, связанные с анализом МРТ-изображений новорожденных. В России таких данных немного, они сосредоточены лишь в отдельных перинатальных центрах. В США при этом существуют открытые массивы изображений, на основе которых проводятся хакатоны, исследования и разработка алгоритмов для более точной разметки и интерпретации данных.
Это особенно важно в тех областях, где знаний и наблюдений пока недостаточно. Например, раннее развитие мозга ребенка все еще изучено значительно хуже, чем более поздние этапы. А качественные данные могут помочь выявлять патологии существенно раньше.
Еще один важный фактор — масштабная грантовая поддержка. Во многих странах медицинские организации объединяются вокруг исследовательских задач, формируют крупные датасеты и развивают прикладную аналитику, в том числе в реанимации и прогнозировании состояния пациента. Там, где такие массивы уже накоплены, информационные системы могут не просто фиксировать происходящее, а прогнозировать развитие ситуации и подсказывать момент, когда терапию нужно начинать незамедлительно.
Кроме того, в зарубежной практике уже появляются сервисы, которые помогают пациенту консолидировать медицинские данные из разных клиник в едином контуре. Это важный ориентир для будущего развития: пациент должен иметь понятный и управляемый доступ к собственному медицинскому профилю, а не зависеть от разрозненных систем разных медорганизаций.
Да, немножко другой уровень развития рынка. И в этой связи завершающий вопрос. Давайте пофантазируем. Как в ближайшие пять лет изменится российский рынок цифрового здравоохранения и как при этом трансформируется роль фармацевтических компаний?
В. К.: Если мы фантазируем, то все будет очень хорошо и быстро. И через пять лет мы подойдем к персонализированному подходу в медицине. Пациенты смогут управлять доступом ко всем своим данным — лечиться в любом регионе России, исходя из истории своей болезни. Фармацевтические компании будут все больше и больше уходить в историю персонализированных лекарственных препаратов. Это отдельный вопрос регуляторики, куда мы продвинемся в этом направлении.
Как раз на основании датасетов пациенты будут получать персонализированную терапию, качественные инновационные лекарственные средства. Это позволит в том числе достигать тех целей, которые мы поставили по продолжительности жизни, и двигаться дальше.
П. П.: В ближайшие годы врачи, безусловно, не исчезнут, но их роль будет меняться. У них появятся цифровые помощники по разным направлениям и патологиям, встроенные в рабочий процесс так, чтобы это было удобно, естественно и действительно ускоряло работу. Одна из ключевых задач — убрать из повседневной практики лишние переходы между системами, дублирование ввода данных и прочие избыточные действия, которые сегодня отнимают слишком много времени.
Логика развития очевидна: данные о пациенте должны вводиться один раз, а затем использоваться во всех последующих сценариях оказания помощи — независимо от того, переходит ли пациент между государственным и коммерческим сегментами. В идеале повторный сбор уже известных данных не потребуется: достаточно будет оформить необходимые согласия и подтвердить действия в электронном виде.
Для врача это означает возможность заранее получить максимальной полный, достоверный, структурированный анамнез по пациенту еще до приема. Для системы здравоохранения и фармацевтической отрасли это открывает более глубокое понимание маршрута пациента: назначения, получение препаратов, ход лечения, динамика состояния.
Как раз на основании датасетов пациенты будут получать персонализированную терапию, качественные инновационные лекарственные средства. Это позволит в том числе достигать тех целей, которые мы поставили по продолжительности жизни, и двигаться дальше.
П. П.: В ближайшие годы врачи, безусловно, не исчезнут, но их роль будет меняться. У них появятся цифровые помощники по разным направлениям и патологиям, встроенные в рабочий процесс так, чтобы это было удобно, естественно и действительно ускоряло работу. Одна из ключевых задач — убрать из повседневной практики лишние переходы между системами, дублирование ввода данных и прочие избыточные действия, которые сегодня отнимают слишком много времени.
Логика развития очевидна: данные о пациенте должны вводиться один раз, а затем использоваться во всех последующих сценариях оказания помощи — независимо от того, переходит ли пациент между государственным и коммерческим сегментами. В идеале повторный сбор уже известных данных не потребуется: достаточно будет оформить необходимые согласия и подтвердить действия в электронном виде.
Для врача это означает возможность заранее получить максимальной полный, достоверный, структурированный анамнез по пациенту еще до приема. Для системы здравоохранения и фармацевтической отрасли это открывает более глубокое понимание маршрута пациента: назначения, получение препаратов, ход лечения, динамика состояния.
По сути, речь идет о формировании целостного жизненного цифрового пути пациента, который имеет огромную ценность и для клинической практики, и для аналитики.
В. К.: Есть еще превентивная медицина и предиктивная аналитика, которые сильно изменят парадигму лечения и терапии, если данные будут доступны. Я очень надеюсь, что с точки зрения, например, онкологии мы будем все больше лечить пациентов на начальных стадиях. Тогда вероятность положительного исхода лечения, ремиссии и полного излечения в разы увеличится. И это тоже про доступ индустрии к обезличенным данным. Уверен, как только рамка обмена такими данными сформируется, появится масса стартапов.
П. П.: Еще один важный момент — доверие пациента к этому лечению. Государство должно последовательно объяснять гражданам, что цифровые сервисы создаются в их интересах и работают на улучшение здоровья населения. Пациент должен понимать ценность такого взаимодействия и не бояться предоставлять доступ к данным, если видит прозрачные правила и понятную для себя пользу. За последние пять-семь лет это направление уже прошло большой путь, и теперь особенно важно планомерно объяснять, как доступ к данным может поддержать превентивную медицину и не только помочь достигать государственных целей в здравоохранении, но и помочь самому пациенту наслаждаться жизнью в здоровом теле.
П. П.: Еще один важный момент — доверие пациента к этому лечению. Государство должно последовательно объяснять гражданам, что цифровые сервисы создаются в их интересах и работают на улучшение здоровья населения. Пациент должен понимать ценность такого взаимодействия и не бояться предоставлять доступ к данным, если видит прозрачные правила и понятную для себя пользу. За последние пять-семь лет это направление уже прошло большой путь, и теперь особенно важно планомерно объяснять, как доступ к данным может поддержать превентивную медицину и не только помочь достигать государственных целей в здравоохранении, но и помочь самому пациенту наслаждаться жизнью в здоровом теле.
Данные и аналитика, упоминаемые в интервью, предоставлены спикерами. Мнение редакции может не совпадать с мнением спикеров.
Василий Король
Директор по работе с данными и цифровыми технологиями AstraZeneca, Россия и Евразия
Окончил МИФИ (Московский инженерно-физический институт), факультет кибернетики, информационных технологий, математики и физики. До прихода в AstraZeneca занимал должности с возрастающей долей ответственности в ведущих банках («ПочтаБанк», «Промсвязьбанк», «Банк Интеза», «Альфа-Банк»).
В AstraZeneca отвечает за реализацию цифровой стратегии компании, включая цифровую трансформацию: создание цифровой экосистемы и омниканальной платформы, внедрение и развитие технологий искусственного интеллекта, а также работу с «большими данными».
В AstraZeneca отвечает за реализацию цифровой стратегии компании, включая цифровую трансформацию: создание цифровой экосистемы и омниканальной платформы, внедрение и развитие технологий искусственного интеллекта, а также работу с «большими данными».
Петр Пузанов
Руководитель направления по автоматизации исследований N3.Health (ООО «ЭлНетМед»)
Окончил СПбГЭТУ «ЛЭТИ» по специальности «Приборостроение»; прошел профпереподготовку по направлению «Организация и технология защиты информации» и курсы повышения квалификации по направлению «Управление цифровой трансформацией».
Работал в СПб ГБУЗ МИАЦ и Комитете по природопользованию, охране окружающей среды и обеспечению экологической безопасности инженером по геоинформационным технологиям, техническим директором ИТ- и ИБ-интегратора в ООО «Новые линии». С 2024 года в N3.Health отвечает за развитие направления обмена данными инструментальных исследований, построение телерадиологической платформы с сервисами искусственного интеллекта.
Работал в СПб ГБУЗ МИАЦ и Комитете по природопользованию, охране окружающей среды и обеспечению экологической безопасности инженером по геоинформационным технологиям, техническим директором ИТ- и ИБ-интегратора в ООО «Новые линии». С 2024 года в N3.Health отвечает за развитие направления обмена данными инструментальных исследований, построение телерадиологической платформы с сервисами искусственного интеллекта.